Таблицы и данные на практике
Сравнить два CSV по ID в Python: новые, исчезнувшие и изменённые записи
Сопоставь записи по устойчивому ID, затем сравни их поля. В двух выгрузках может быть по три записи, хотя один ID исчез, другой появился, а ещё одна запись изменилась.
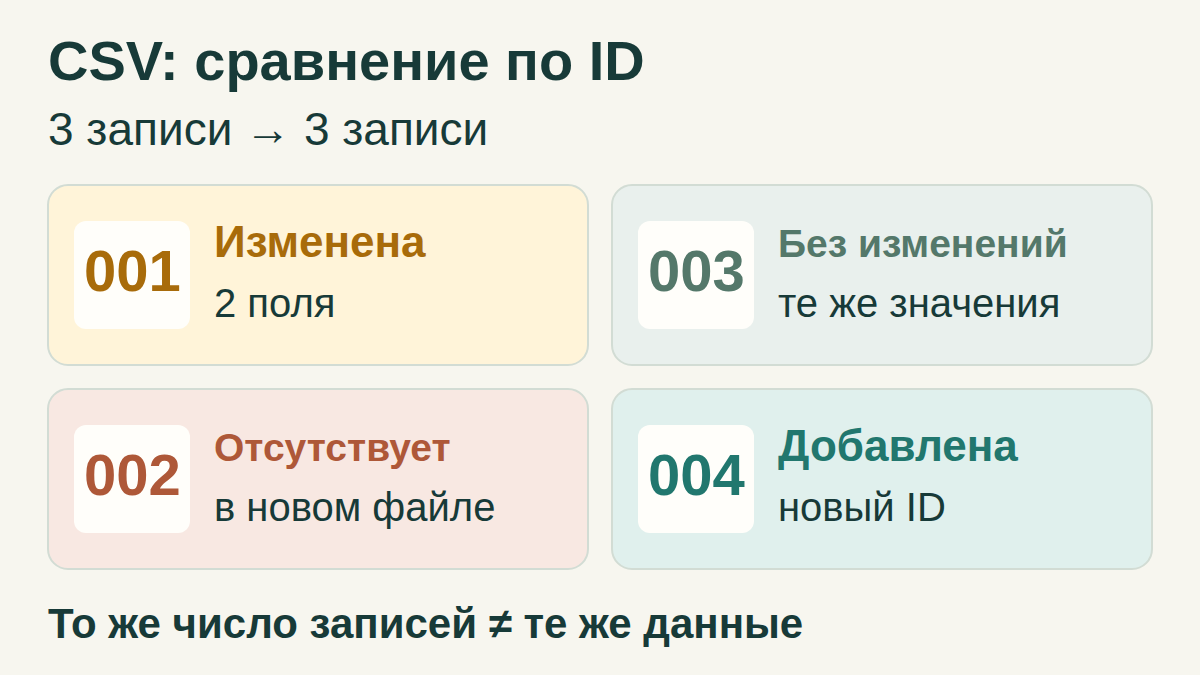
Сначала сопоставь ID
Построчное сравнение создаёт лишний шум, когда выгрузку отсортировали иначе. Этот способ сопоставляет одну запись старого CSV с одной записью нового CSV по одинаковому ID. В отчёт попадают ID только из нового файла, ID только из старого и изменившиеся поля общих записей.
Выбери столбец, который однозначно определяет запись в обеих выгрузках. ID покупателя не подходит, если у покупателя несколько заказов. Скрипт принимает один ключевой столбец и не подбирает составной ключ.
1. Попробуй две выгрузки по три записи
Сохрани эти вымышленные данные о канцелярских товарах как old.csv и new.csv в UTF-8. В каждом файле есть заголовок и три записи данных. Порядок записей меняется; запятая в новом названии заключена в кавычки и относится к одному полю.
old.csv
csv
id,label,qty
001,Blue folder,12
002,Index cards,40
003,Paper clips,25
new.csv
csv
id,label,qty
004,Sticky notes,8
003,Paper clips,25
001,"Blue folder, A4",10
Ожидаемый результат
- 004 появилась: этот ID есть только в new.csv.
- 002 исчезла из этой выгрузки: этот ID есть только в old.csv.
- 001 — одна изменённая запись с двумя изменёнными ячейками: label меняется с Blue folder на Blue folder, A4, а qty — с 12 на 10.
- 003 не изменилась, хотя переместилась.
2. Сохрани скрипт для локального сравнения
Сохрани весь код ниже как compare_csv.py рядом с двумя CSV. Он использует стандартную библиотеку Python. Мы проверили его в Python 3.12.3 на Linux; инструкция рассчитана на тех, кто уже умеет запускать Python из терминала.
Скрипт читает оба файла и печатает JSON. Он не отправляет сетевые запросы и не записывает данные во входные файлы. Используй стабильные локальные копии, которые не редактируются во время сравнения. Оба разобранных файла и результат хранятся в памяти: выбирай выгрузки, которые помещаются в неё с запасом.
compare_csv.py
python
import argparse
import csv
import json
import sys


def read_snapshot(path, key, delimiter):
    with open(path, encoding="utf-8-sig", newline="") as source:
        reader = csv.reader(source, delimiter=delimiter, strict=True)
        try:
            header = next(reader, None)
            if not header or any(not name.strip() for name in header):
                raise ValueError(f"{path}: missing or blank column name")
            if len(header) != len(set(header)):
                raise ValueError(f"{path}: duplicate column name")
            if key not in header:
                raise ValueError(f"{path}: missing key column {key!r}")
            records = {}
            for row in reader:
                where = f"{path}: record ending at line {reader.line_num}"
                if len(row) != len(header):
                    raise ValueError(f"{where}: expected {len(header)} fields, "
                                     f"got {len(row)}")
                record = dict(zip(header, row))
                identifier = record[key]
                if not identifier.strip():
                    raise ValueError(f"{where}: blank ID")
                if identifier in records:
                    raise ValueError(f"{where}: duplicate ID {identifier!r}")
                records[identifier] = record
        except csv.Error as exc:
            raise ValueError(f"{path}: CSV error near line "
                             f"{reader.line_num}: {exc}") from exc
    return set(header), records


def compare(old, new, columns, key):
    old_ids, new_ids = set(old), set(new)
    added = sorted(new_ids - old_ids)
    removed = sorted(old_ids - new_ids)
    changed = {}
    changed_cells = 0
    for identifier in sorted(old_ids & new_ids):
        fields = {}
        for column in sorted(columns - {key}):
            before, after = old[identifier][column], new[identifier][column]
            if before != after:
                fields[column] = {"old": before, "new": after}
        if fields:
            changed[identifier] = fields
            changed_cells += len(fields)
    return {
        "summary": {
            "old_records": len(old),
            "new_records": len(new),
            "unchanged_records": len(old_ids & new_ids) - len(changed),
            "changed_records": len(changed),
            "added_records": len(added),
            "removed_records": len(removed),
            "changed_cells": changed_cells,
        },
        "added": added,
        "removed": removed,
        "changed": changed,
    }


def main():
    parser = argparse.ArgumentParser(description="Compare CSV snapshots by ID.")
    parser.add_argument("old_csv")
    parser.add_argument("new_csv")
    parser.add_argument("--key", default="id")
    parser.add_argument("--delimiter", default=",")
    args = parser.parse_args()
    if len(args.delimiter) != 1 or args.delimiter in '\r\n\0"':
        parser.error("delimiter must be one character, excluding CR, LF, NUL and quote")
    try:
        old_columns, old = read_snapshot(args.old_csv, args.key, args.delimiter)
        new_columns, new = read_snapshot(args.new_csv, args.key, args.delimiter)
        if old_columns != new_columns:
            missing = sorted(old_columns - new_columns)
            extra = sorted(new_columns - old_columns)
            raise ValueError(f"column sets differ: missing in new={missing!r}; "
                             f"extra in new={extra!r}")
        result = compare(old, new, old_columns, args.key)
    except (OSError, UnicodeError, ValueError) as exc:
        print(f"Error: {exc}", file=sys.stderr)
        return 1
    print(json.dumps(result, ensure_ascii=True, indent=2, sort_keys=True))
    return 0


if __name__ == "__main__":
    sys.exit(main())
3. Запусти из этой папки
Первый путь указывает на старую выгрузку, второй — на новую. Меняй их местами только для обратного сравнения. Вместо id укажи точное имя ключевого столбца; пути с пробелами заключи в кавычки.
Сравнить пример
sh
python3 compare_csv.py old.csv new.csv --key idВыбери разделитель
По умолчанию разделитель — запятая. Если оба файла разделены точкой с запятой, добавь --delimiter ";". У файлов должны совпадать разделитель и правила двойных кавычек. Скрипт не угадывает кодировку или формат.
Для файлов с точкой с запятой
sh
python3 compare_csv.py old.csv new.csv --key id --delimiter ";"4. Считай записи и ячейки отдельно
Массивы added и removed в JSON содержат ID, а не записи целиком. Объект changed группирует изменённые ячейки по ID и показывает старую и новую строку значения. Два поля у 001 относятся к одной изменённой записи. Неизменившаяся запись 003 учитывается в сводном числе, но отдельно не перечисляется.
Ожидаемая сводка
json
{
  "added_records": 1,
  "changed_cells": 2,
  "changed_records": 1,
  "new_records": 3,
  "old_records": 3,
  "removed_records": 1,
  "unchanged_records": 1
}
Это поля объекта summary. Полный JSON также содержит added, removed и changed.
Проверь баланс записей
Для старой выгрузки: неизменённые + изменённые + исчезнувшие = 1 + 1 + 1 = 3. Для новой: неизменённые + изменённые + добавленные = 1 + 1 + 1 = 3. Считай изменённую запись один раз, даже если поменялось несколько ячеек.
Поэтому одинаковое общее число записей не доказывает, что данные совпадают. В примере неизменной осталась только одна из трёх записей.
Короткая контрольная проверка
Запусти команду с old.csv на обеих позициях входного файла. Сводка должна показать три неизменённые записи и ноль добавленных, исчезнувших и изменённых. Затем создай отдельную копию, где изменён только порядок этих строк: результат должен остаться таким же. Перестановка столбцов тоже ничего не меняет, если их имена и соответствующие значения сохранены.
Что считается различием
- ID и значения остаются строками. ID 001 и 1 различаются; значения 10 и 10.0 тоже. Ведущие нули сохраняются.
- Пробелы, регистр букв и формы Unicode не нормализуются. Непустой ID с пробелом в конце отличается от такого же видимого ID без пробела.
- Сначала разбирается синтаксис CSV: 001 и "001" означают одинаковое значение поля. Необязательный UTF-8 BOM в начале файла игнорируется.
- Запятые и переводы строк внутри кавычек остаются частью поля. Разные символы перевода строки внутри поля могут считаться изменением.
- Изменённый ID выглядит как один исчезнувший и один добавленный. Скрипт не может установить, что за ними стоит одна и та же реальная запись.
Если скрипт сообщает об ошибке
Пустое или повторяющееся имя столбца, отсутствие ключевого столбца, пустой или состоящий из пробелов ID, повтор ID, неверное число полей или нечитаемый UTF-8 останавливают обработку. Повтор ID запрещён даже при одинаковых строках: сопоставление неоднозначно. Наборы имён столбцов должны совпадать, но их порядок может различаться.
Файл только с заголовком допустим: в нём ноль записей. Полностью пустой файл недопустим. Пустые записи между строками данных отклоняются. Действует обычный лимит Python на размер поля. strict=True выявляет часть ошибок кавычек, но не проверяет все возможные варианты CSV.
При ошибках входных данных скрипт пишет Error в стандартный поток ошибок и возвращает ненулевой код завершения без частичного JSON-отчёта. Исправь данные или настройки разбора, прежде чем использовать результат. Успешное сравнение возвращает код 0, даже если различия найдены.
Как понимать «исчезнувшие»
Исчезнувшая запись — это запись, которой нет во втором файле по выбранному ключу. Проверь, что обе выгрузки охватывают один набор данных, фильтры и период, а выгрузка и синхронизация завершены. Отсутствие в неполной или отфильтрованной выгрузке не доказывает удаление из исходной системы.
Если сохраняешь JSON перенаправлением вывода в оболочке, выбери отдельное имя отчёта. Оболочка может обнулить файл назначения ещё до запуска Python: никогда не направляй вывод ни в один из входных файлов.