Таблицы и данные на практике
Как найти дубли в CSV и не удалить разные записи с одним ID
Полностью одинаковая запись и повторяющийся ID — разные результаты проверки. Локальный скрипт показывает оба, сохраняет начальные нули и пробелы и не меняет исходный CSV.
Сначала определите, что считать дублем
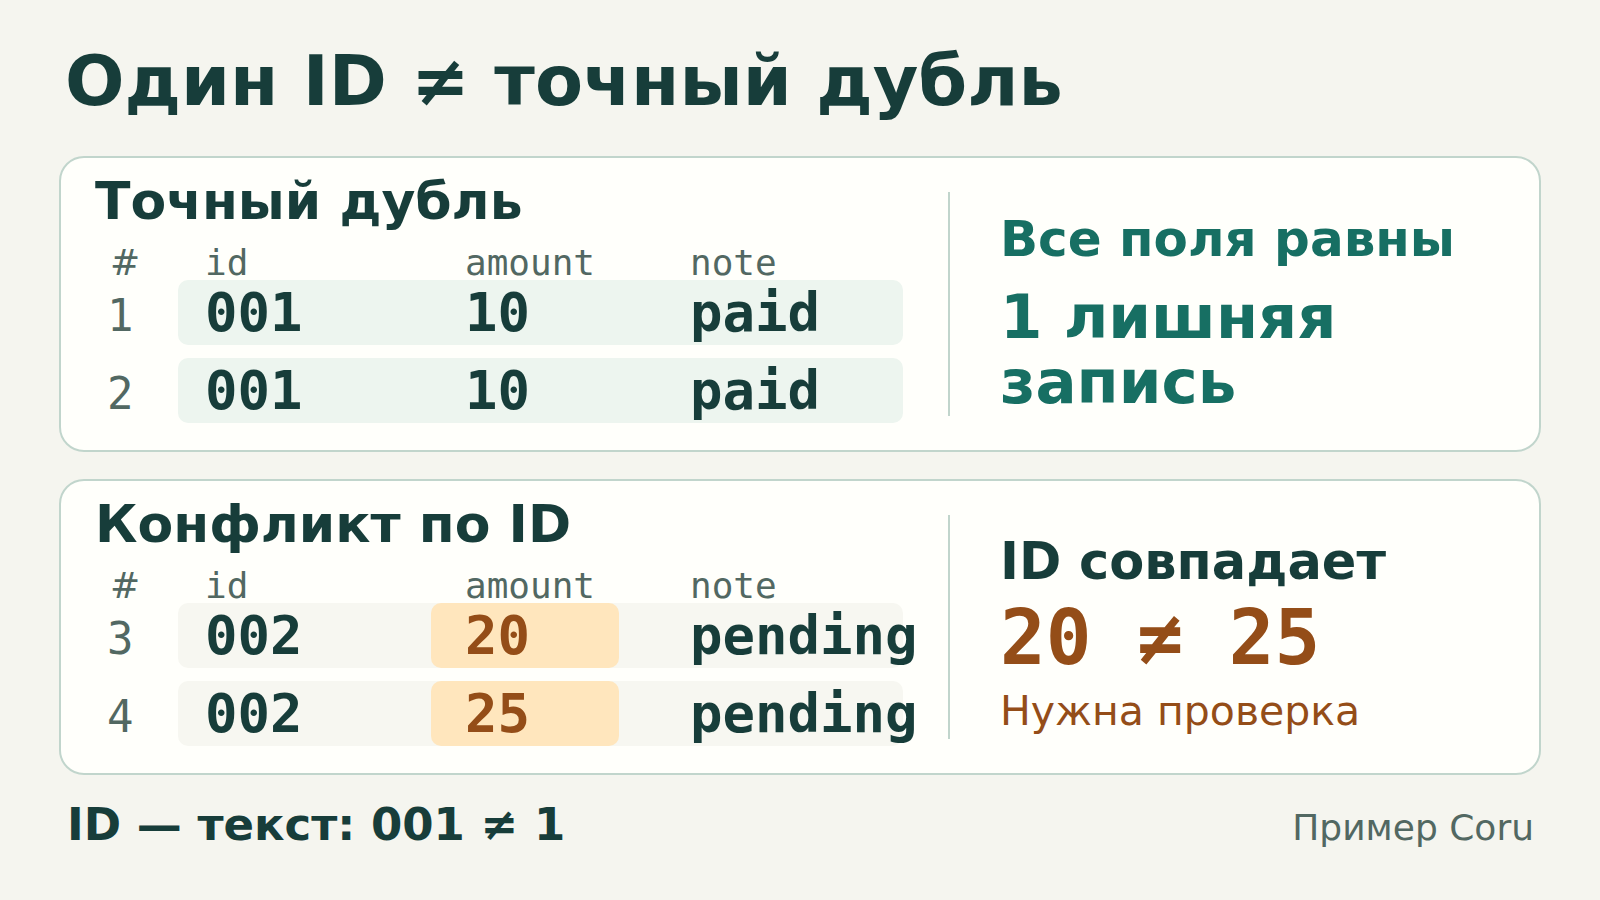
Две записи CSV могут иметь одинаковый ID, но разные суммы, адреса или статусы. Удаление всех повторяющихся ID скроет это расхождение. Начните с двух отдельных проверок: полностью одинаковые записи и повторяющиеся ID, которым соответствуют разные записи.
Здесь точный дубль означает совпадение строковых значений всех разобранных полей в том же порядке столбцов. Это не равенство исходных байтов CSV: 001 и "001" превращаются в одинаковое значение. Конфликтующий ID — непустой идентификатор, которому соответствуют хотя бы две разные полные записи. Является ли расхождение ошибкой, зависит от смысла ID.
1. Попробуйте пример из пяти записей
Сохраните этот текст как sample.csv в UTF-8. Первая запись CSV — заголовок; записи данных нумеруются с 1 после него. ID 001 повторяется с одинаковой суммой и примечанием. У ID 002 две разные суммы. ID 003 встречается один раз.
sample.csv
csv
id,amount,note
001,10,paid
001,10,paid
002,20,pending
002,25,pending
003,30,paid
Сохраняйте эти значения как текст. Начальные нули — часть каждого ID.
2. Запустите локальную проверку без изменения файла
Нужен Python 3. Сохраните полный скрипт ниже как check_csv.py рядом с sample.csv. Дополнительные библиотеки не нужны. Мы проверили примеры в Python 3.12.3 на Linux. Скрипт открывает исходник для чтения и печатает отчёт JSON; очищенный CSV он не создаёт и сетевых запросов не делает.
Используйте локальную копию, которую никто не редактирует во время проверки. Скрипт держит в оперативной памяти разные записи, их номера и группы ID. Потребление памяти растёт вместе с исходником. Начните с небольших выгрузок, которые уверенно помещаются в память; этот способ не рассчитан на файлы произвольного размера.
check_csv.py
python
import argparse
import csv
import json


def inspect_csv(path, key, delimiter):
    rows, keys, empty_ids = {}, {}, []
    total = 0
    with open(path, encoding="utf-8-sig", newline="") as source:
        reader = csv.reader(source, delimiter=delimiter, strict=True)
        header = next(reader, None)
        if not header or any(name == "" for name in header):
            raise ValueError("missing or empty header name")
        if len(set(header)) != len(header):
            raise ValueError("duplicate header name")
        if key not in header:
            raise ValueError(f"ID column not found: {key!r}")
        column = header.index(key)
        for total, fields in enumerate(reader, 1):
            if len(fields) != len(header):
                raise ValueError(
                    f"record {total}, ending on line {reader.line_num}: "
                    f"expected {len(header)} fields, got {len(fields)}"
                )
            row = tuple(fields)
            rows.setdefault(row, []).append(total)
            value = fields[column]
            if value == "":
                empty_ids.append(total)
            else:
                keys.setdefault(value, set()).add(row)
    duplicates = [numbers for numbers in rows.values() if len(numbers) > 1]
    conflicts = [
        {"id": value, "records": sorted(n for row in variants for n in rows[row])}
        for value, variants in keys.items() if len(variants) > 1
    ]
    return {
        "records": total,
        "exact_duplicate_groups": duplicates,
        "extra_exact_records": sum(len(group) - 1 for group in duplicates),
        "conflicting_ids": conflicts,
        "empty_id_records": empty_ids,
    }


def main():
    parser = argparse.ArgumentParser(description="Inspect CSV; do not change it.")
    parser.add_argument("file")
    parser.add_argument("id_column")
    parser.add_argument("--delimiter", choices=[",", ";", "\t"], default=",")
    args = parser.parse_args()
    try:
        report = inspect_csv(args.file, args.id_column, args.delimiter)
    except (OSError, UnicodeError, csv.Error, ValueError) as error:
        parser.exit(1, f"No report: {error}\n")
    print(json.dumps(report, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
Исходник должен быть в UTF-8 с необязательным BOM в начале и иметь заголовок с непустыми, неповторяющимися именами.
Запустите из папки с обоими файлами
bash
python3 -B check_csv.py sample.csv idПоследний аргумент — точное имя столбца с идентификатором, с учётом регистра.
Выберите разделитель явно
По умолчанию разделитель — запятая. Для файла с точкой с запятой добавьте к команде --delimiter ";". Скрипт также принимает настоящий символ табуляции в аргументе разделителя. Для заключённых в кавычки полей используются двойные кавычки; внутренняя двойная кавычка удваивается. Кодировка, разделитель, наличие заголовка и столбец ID не угадываются. Для другой системы кавычек нужна соответствующая настройка парсера.
Отчёт для sample.csv
json
{
  "records": 5,
  "exact_duplicate_groups": [
    [
      1,
      2
    ]
  ],
  "extra_exact_records": 1,
  "conflicting_ids": [
    {
      "id": "002",
      "records": [
        3,
        4
      ]
    }
  ],
  "empty_id_records": []
}
Отчёт появляется только после успешного чтения всего исходника.
3. Читайте два результата отдельно
- records равно 5: заголовок не учитывается. В exact_duplicate_groups указано [1, 2] — эти две записи полностью совпадают.
- extra_exact_records равно 1: в группе из двух записей есть одно вхождение сверх первого. Это описание количества, а не разрешение удалить запись.
- conflicting_ids указывает ID 002 и записи [3, 4]. Посмотрите на столбец amount: значения 20 и 25 различаются. Оставив первую или последнюю запись, вы выберете сумму, ещё не установив, какая верна.
- empty_id_records здесь пуст. В вашем файле в этот список попадут записи с точно пустым ID; они исключаются из группировки конфликтов по ID. При этом их полные записи участвуют в поиске точных дублей.
Категории могут пересекаться
Если в файле две одинаковые копии 002,20,pending и ещё одна запись 002,25,pending, первые две образуют группу точных дублей, а все три относятся к одному конфликтующему ID. Нельзя складывать длины двух списков, чтобы получить число записей для удаления.
Повторение ID подозрительно, только если этот столбец должен определять одну запись. Код клиента может законно встречаться в нескольких заказах. Если уникальность определяется несколькими столбцами, проверки по одному недостаточно: сначала установите составной ключ, затем решайте, какие расхождения важны.
Какие различия сохраняются
Проверка не обрезает пробелы, не меняет регистр, не нормализует Unicode и не преобразует числа. ID 001 и 1 остаются разными. ID из одного пробела не считается пустым. Строки суммы 10 и 10.0 различаются, как и paid и paid с пробелом в конце. Буквальное сравнение показывает различия оформления, не решая за вас, что ими можно пренебречь.
Запятая или перенос строки внутри кавычек — часть поля. Поэтому запись 3 не обязательно находится на физической строке 4 в редакторе. Символы переноса внутри заключённого в кавычки поля тоже сравниваются буквально: CRLF и LF могут дать конфликт. Необязательный BOM UTF-8 убирается только в начале файла.
Если проверка остановилась
Отсутствующий заголовок, пустое или повторяющееся имя столбца, отсутствие столбца ID, неверное число полей либо недекодируемый UTF-8 останавливают выполнение. Пустая запись CSV вне поля в кавычках отвергается как запись без полей; запись из пустых полей правильной ширины — другой случай. Файл только с заголовком успешно даёт ноль записей данных.
Парсер работает с strict=True, но это не полная проверка всех правил и вариантов CSV. В нашем прогоне незакрытое поле в кавычках и текст после закрывающей кавычки дали ошибку, а кавычка внутри поля без внешних кавычек была принята. Обычный предел размера поля Python также сохраняется. Даже поздняя ошибка приводит к “No report”, а не неполному отчёту JSON. Исправьте исходник или настройки и повторите запуск.
Перед удалением записей
Сохраните оригинал, просмотрите указанные записи и подтвердите рабочий смысл ID. Даже одинаковые записи могут описывать отдельные реальные события. При расхождениях сравните значения с исходной выгрузкой или системой, отвечающей за запись, и установите правило разрешения конфликта. После согласованной очистки отдельной копии повторите проверку и сверьте итоговое число записей. Отчёт без конфликтов доказывает лишь отсутствие разных записей для каждого непустого ID в выбранном столбце при этих правилах буквального сравнения.