Таблицы и данные на практике
Как объединить CSV в Python без повторных заголовков и повреждённых полей
Объедините небольшие CSV в UTF-8 с одним заголовком: проверьте исходники до записи и сверяйте результат по примеру с нулями, длинными ID и заметками в кавычках.
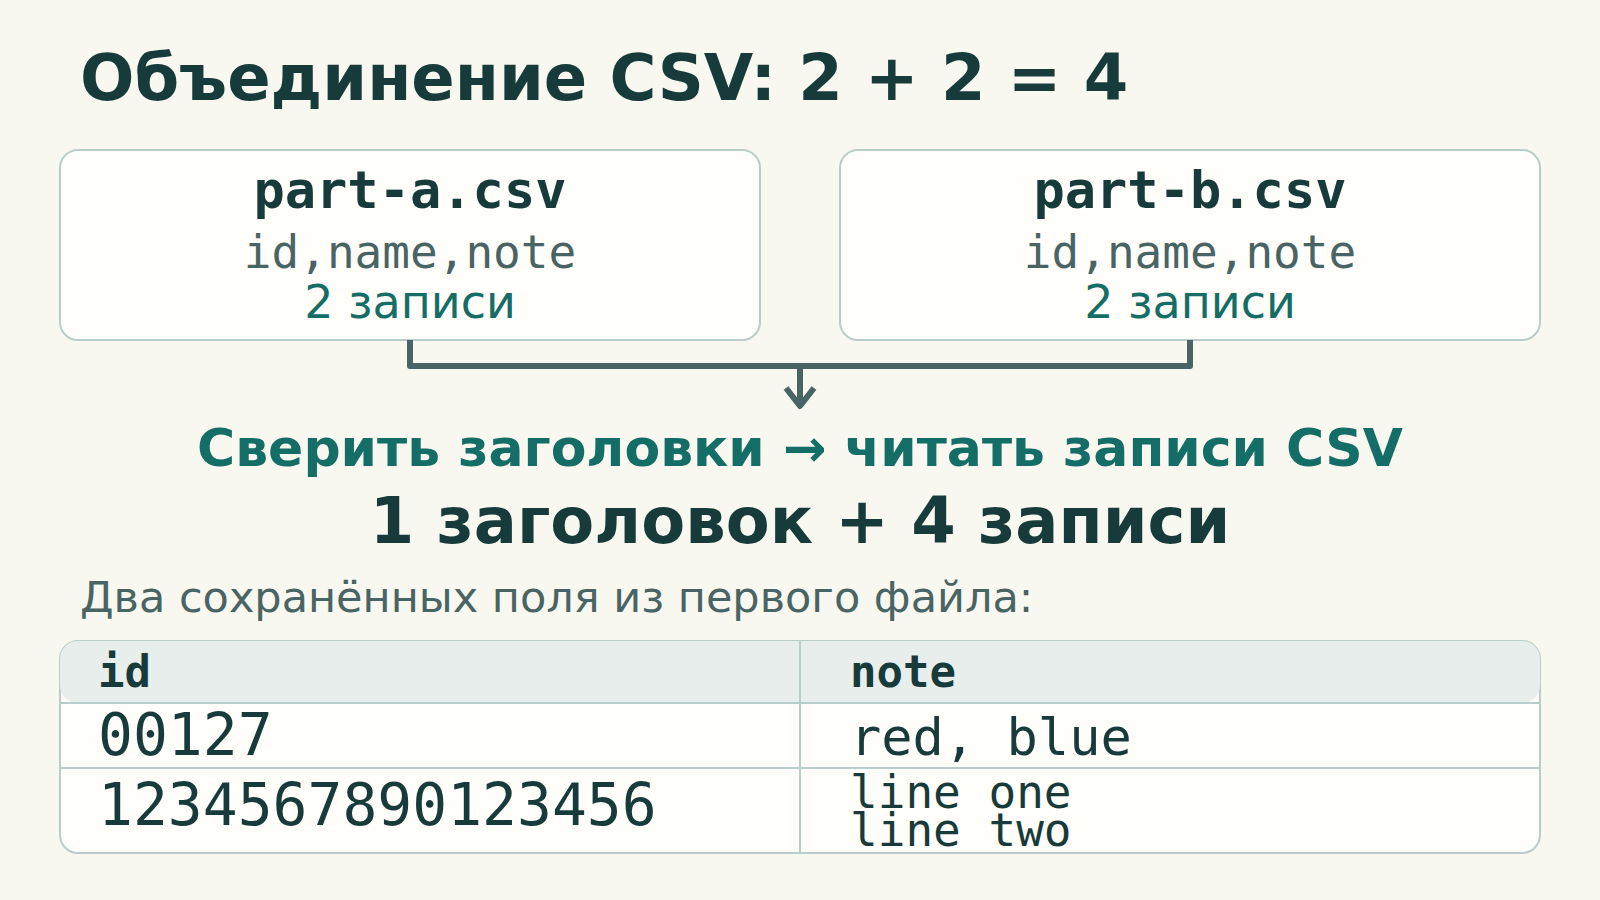
Добавьте записи из файлов с одинаковыми столбцами
Прочитайте CSV модулем csv, сравните заголовки всех файлов и запишите заголовок один раз. Скрипт ниже сохраняет значения полей как текст, в том числе ведущие нули и длинные идентификаторы. Он добавляет записи друг под другом; не соединяет таблицы по ID и не удаляет повторяющиеся записи данных.
Способ рассчитан на два или больше небольших файлов UTF-8, с BOM или без него, с запятыми между полями и двойными кавычками вокруг полей, которым нужны кавычки. Сначала подтвердите этот формат. Разобранные данные должны свободно помещаться в оперативную память: это не потоковая обработка больших выгрузок. Имена столбцов должны быть непустыми, уникальными и одинаковыми во всех файлах, включая порядок.
1. Сохраните два проверочных файла
Сохраните их как обычный текст UTF-8 в одной папке. Оставьте перенос строки внутри заметки Bo в кавычках. В каждом файле один заголовок и две записи данных, хотя part-a.csv занимает четыре физические строки. Идентификаторы и имена вымышлены.
part-a.csv
csv
id,name,note
00127,Анна,"red, blue"
1234567890123456,Bo,"line one
line two"
part-b.csv
csv
id,name,note
00009,Chen,"He said ""yes"""
1234567890123457,Дина,ready
2. Сохраните и запустите полный скрипт
Сохраните код как merge_csv.py в той же папке. Нужна только стандартная библиотека Python 3. Скрипт читает и проверяет все входные файлы до создания результата; при отклонении входных данных новый выходной файл не появляется. Существующий выходной файл не перезаписывается. Во время работы не меняйте исходники.
merge_csv.py
python
import csv
import sys
from pathlib import Path


def merge(output, names):
    target = Path(output).resolve()
    inputs = [Path(name).resolve(strict=True) for name in names]
    if len(set(inputs)) != len(inputs):
        raise ValueError("An input path was listed twice")
    if target in inputs or target.exists():
        raise ValueError("Output must be a new file, separate from inputs")
    header, rows = None, []
    for path in inputs:
        with path.open(encoding="utf-8-sig", newline="") as source:
            reader = csv.reader(source, delimiter=",", strict=True)
            try:
                current = next(reader, None)
                if not current or any(not name.strip() for name in current):
                    raise ValueError(f"{path.name}: missing or blank header")
                if len(set(current)) != len(current):
                    raise ValueError(f"{path.name}: duplicate column name")
                if header is None:
                    header = current
                elif current != header:
                    raise ValueError(f"{path.name}: headers differ in name/order")
                for row in reader:
                    location = f"{path.name}: physical line {reader.line_num}"
                    if not row or len(row) != len(header):
                        raise ValueError(f"{location}: blank row or wrong field count")
                    if row == header:
                        raise ValueError(f"{location}: repeated header inside file")
                    rows.append(row)
            except csv.Error as error:
                raise ValueError(f"{path.name}: line {reader.line_num}: {error}") from error
    with target.open("x", encoding="utf-8", newline="") as destination:
        writer = csv.writer(destination, delimiter=",")
        writer.writerow(header)
        writer.writerows(rows)
    print(f"Wrote {len(rows)} data records from {len(inputs)} files to {target.name}")


if __name__ == "__main__":
    if len(sys.argv) < 4:
        sys.exit("Usage: python3 merge_csv.py output.csv input-a.csv input-b.csv [...]")
    try:
        merge(sys.argv[1], sys.argv[2:])
    except (OSError, UnicodeError, ValueError) as error:
        sys.exit(f"ERROR: {error}")
Запустите из папки с тремя файлами
text
python3 merge_csv.py merged.csv part-a.csv part-b.csvЯвно задайте имя результата и исходные файлы
Первое имя — новый выходной файл; остальные — исходники в нужном порядке записей. Укажите каждый исходник один раз; пути с пробелами заключайте в кавычки. Не подставляйте *.csv: в список может попасть старый результат. В Windows используйте py -3 вместо python3, если Python запускается у вас этой командой.
Сообщение об успехе
text
Wrote 4 data records from 2 files to merged.csv3. Проверьте результат как записи CSV
Получатся три столбца, один заголовок и четыре записи данных. Шесть физических строк — ожидаемый результат: внутри одной заметки есть перенос строки. Значения 00127, 00009, 1234567890123456 и 1234567890123457 должны сохраниться точно. Анна и Дина должны остаться читаемыми; заметка Bo — одним полем, а заметка Chen — текстом He said "yes".
merged.csv: ожидаемый текст
csv
id,name,note
00127,Анна,"red, blue"
1234567890123456,Bo,"line one
line two"
00009,Chen,"He said ""yes"""
1234567890123457,Дина,ready
Что проверяет скрипт
- Заголовок следующего файла должен точно совпадать с первым, включая порядок столбцов, регистр и пробелы. Скрипт не переставляет столбцы.
- Пустая запись CSV или запись с неверным числом полей останавливает объединение. Пустые поля допустимы: ,, — запись из трёх полей. Обычный завершающий перенос строки не создаёт лишнюю пустую запись.
- Запись, совпадающая с заголовком внутри файла, останавливает объединение для проверки. Заголовком считается только первая запись каждого исходника; совпавшие данные не удаляются молча.
- strict=True отклоняет ошибки разбора, например незакрытое поле в кавычках или лишний текст после закрывающей кавычки. Это не полная проверка формата CSV: Python может принять кавычку внутри поля без обрамляющих кавычек.
- Ошибка декодирования UTF-8 останавливает объединение. utf-8-sig убирает необязательный BOM в начале каждого исходника; результат записывается в UTF-8 без BOM.
Зачем нужен разбор CSV?
Простая склейка файлов повторяет их заголовки. Разбиение текста по каждой запятой или переносу строки не различает разделитель и содержимое поля в кавычках. newline="" передаёт обработку переносов строк модулю csv; writer добавляет кавычки там, где они нужны. Результат сохраняет разобранные значения полей, а не исходный выбор кавычек или окончаний записей.
Числовое преобразование не задано, поэтому reader возвращает строки. Это сохраняет идентификаторы при объединении. При открытии результата в табличном редакторе возможны его собственные преобразования; в Excel импортируйте столбцы идентификаторов как текст.
Завершайте работу только после успешной проверки
На своих исходниках сравните показанное число записей с суммой записей данных во всех файлах, затем проверьте несколько известных идентификаторов и заметок в кавычках. Сохраните исходники. Сообщение об ошибке, прерывание или сбой записи на диск означают, что результат нельзя принимать: ошибка во время записи может оставить неполный файл, а следующий запуск откажется его перезаписывать. Проверьте его и выберите новое имя результата перед повторной попыткой.
Мы запустили именно этот скрипт на Python 3.12.3: пример с двумя файлами и 29 проверок прошли, включая отклонение неверных заголовков, числа полей, ошибок кавычек, неправильного UTF-8 и попыток перезаписи. Также проверены BOM, пустые поля и CRLF внутри поля в кавычках. Табличный редактор не запускался. Для файлов с разными схемами, кодировками или разделителями сначала нужен явно заданный способ преобразования.